计划任务与 Cron 调度引擎职责
全面解析 cron 目录、后台线程守护与 state.db 并发冲突规避机理
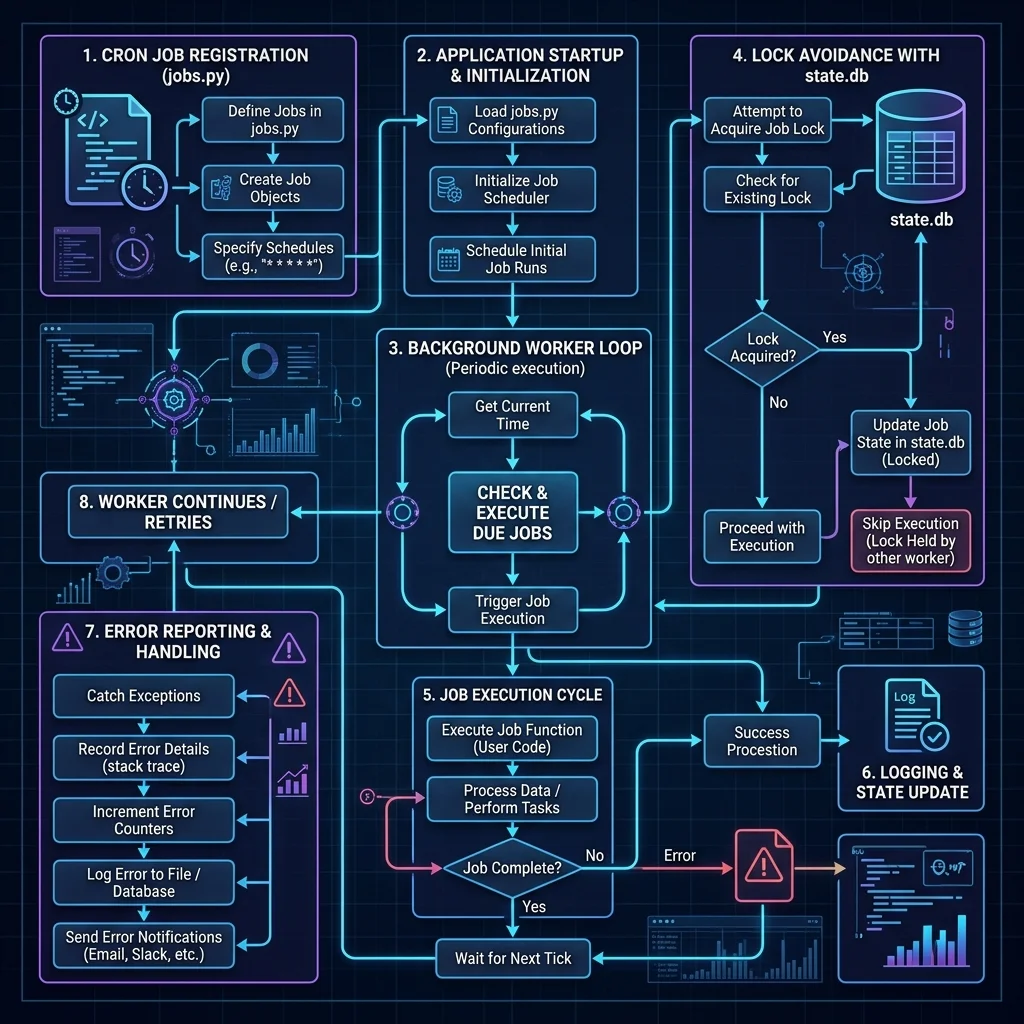
📊 图 8-1:Cron 计划任务并发运行调度、避锁机制与多级容错流转图
⏰ 1. 计划任务在项目中的定位
为了支持周期性的自动巡检、日常报告生成和多平台的心跳检测,Hermes 内置了一个极轻量的 Cron 计划任务调度器。代码资产被集中在项目 cron/ 目录下:
cron/jobs.py:任务注册器。所有的自动化工作任务(如“CEO小时引擎”、“战略校准”)均在此定义调度参数与执行时段(使用标准的 5 位 Cron 语法定义,如*/5 * * * *每五分钟调度)。cron/scheduler.py:后台核心守护引擎。在系统服务拉起时,在独立的后台守护线程(Daemon Thread)中维护无限 Tick 轮询心跳。
🔒 2. 后台任务与前台交互的 state.db 并发冲突规避
由于 Cron 任务经常被拉起在后台默默执行,它可能会与前台用户在 TUI 上的提问、或飞书消息网关抛来的用户消息发生**写入重合**。如果双方同时对 state.db 中的会话状态表发起写入,就会引发 SQLite 的 Busy Locked 崩溃。为此,计划任务遵循避堵三策:
- 应用层锁探测:Cron 在尝试向 `state.db` 更新任务执行状态前,会先尝试去申请全局 `compression_locks` 或读取当前的写事务。
- Jitter 重试降噪:当遇到写冲突锁时,Cron 线程会自动释放 Python 级锁,在
20ms - 150ms之间随机休眠后进行 Jitter 重试,打散抢锁时序,从而将锁争用降低为零。 - 排他降级:如果冲突严重,Cron 会暂时跳过非关键的状态回写,直接把任务成果输出推送到网关端交付,防止为了回写日志而导致大模型当前核心任务回滚。
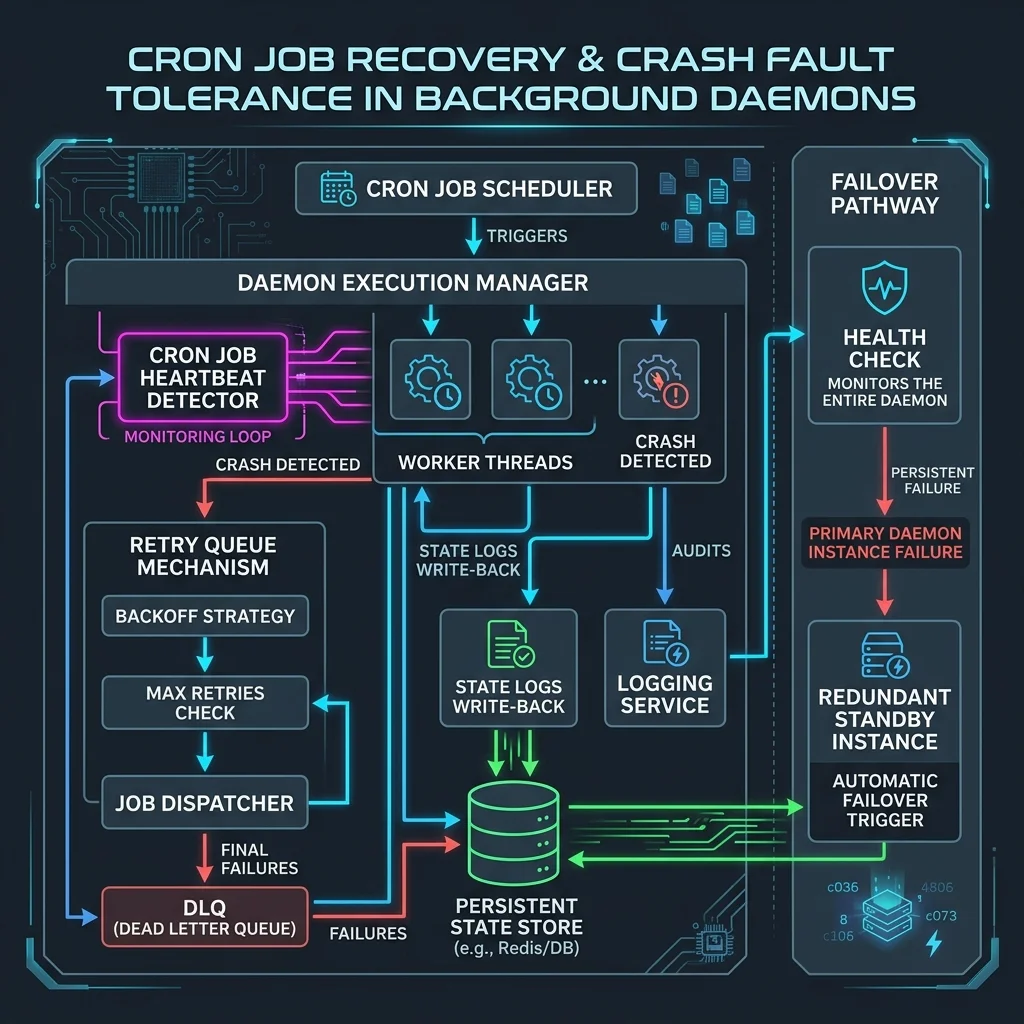
📊 图 8-2:Cron 任务崩溃容错监测、自愈重试与死信队列(DLQ)流转图
🩹 3. 多级容错自愈与日志持久化
后台计划任务通常是无人值守运行的,因此对健壮性的要求非常苛刻。cron/scheduler.py 中实现了多级容错捕获:
# cron/scheduler.py 任务调度容错逻辑
def run_job(self, job):
    try:
        # Step 1: 预检 API 连接与 Token 预算
        self.verify_model_connectivity()

        # Step 2: 启动任务执行
        job.execute()

        # Step 3: 更新执行成功日志
        self.update_job_status(job.id, "SUCCESS")
    except Exception as exc:
        # Step 4: 捕获异常,记录详细堆栈
        logger.error(f"Job '{job.name}' failed: {exc}", exc_info=True)
        # 持久化报错信息至 state.db
        self.update_job_status(job.id, "FAILED", error_detail=str(exc))
        # Step 5: 向管理员网关通道发送紧急报警气泡通知
        self.broadcast_admin_alert(job.name, exc)
通过这套自愈机制,即使某个 Cron 任务由于网络超时抛错崩溃,整个守护引擎仍能保持极高的可用性,并在下一次 Tick 周期中自适应重建心跳。
🔗 本章子任务深入剖析专栏
为深度掌握 Cron 计划任务调度器,推荐阅读以下子技术专题: