计算层:并行批处理引擎与并发控制
深度剖析 batch_runner.py 任务分解、线程池(ThreadPoolExecutor)隔离与 API 容错退避
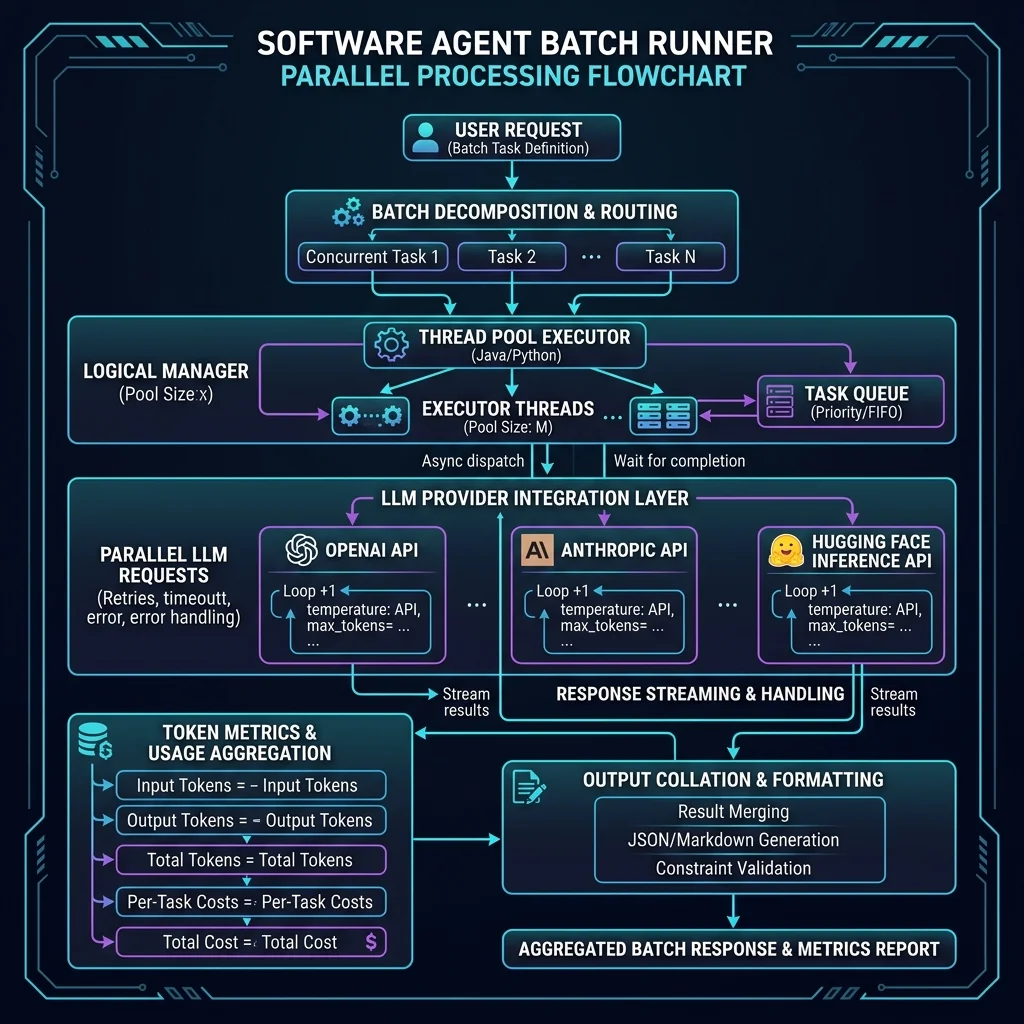
📊 图 12-1:批量任务并发分解、ThreadPoolExecutor 线程调度与多 Token 指标聚合流
⚡ 1. batch_runner.py 职责与并行架构
在面对大量评估任务或者海量自动推流处理时,单线程顺序运行会导致极长的延迟。为此,项目提供了 batch_runner.py 并行执行引擎:
- 任务切片分解 (Batch Decomposition):将单一庞大的数据流或任务配置分解成相互独立的子任务列表。
- ThreadPoolExecutor 并发池:系统通过
concurrent.futures.ThreadPoolExecutor控制并发度。池大小(Pool Size)在启动时动态探测主机 CPU 和 API 限流值(Rate Limits),确保并发在安全范围内。
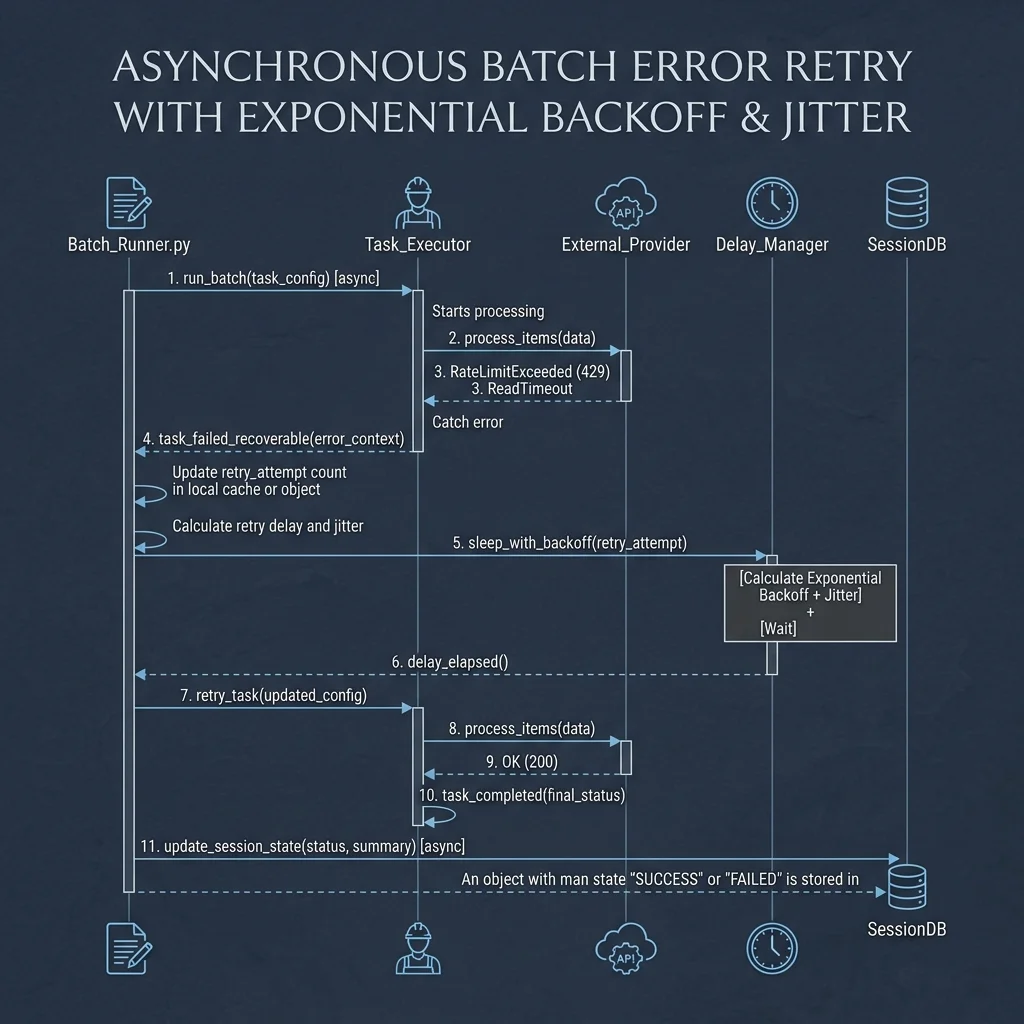
📊 图 12-2:UML 序列图:异步批处理大模型请求错误捕获、Jitter 指数退避重试与 DB 锁一致性回写
📈 2. Token 指标计量与并发成本核算
并发执行最难保证的是对各路接口产生的 Token 使用情况和成本的归口统计。batch_runner.py 提供了线程安全的共享状态计量:
# batch_runner.py 中的共享计量逻辑示例
from dataclasses import dataclass
import threading

@dataclass
class TokenCounter:
    input_tokens: int = 0
    output_tokens: int = 0
    total_cost: float = 0.0
    _lock = threading.Lock()

    def add_usage(self, input_t, output_t, cost):
        # 强制并发加锁,规避竞争读写导致的计量漏洞
        with self._lock:
            self.input_tokens += input_t
            self.output_tokens += output_t
            self.total_cost += cost
通过线程级共享锁,即使有几十个子智能体同时完成交互并返回,总成本数据依然可以保证强一致性,最终输出成精美的 JSON/Markdown 指标报表。
🛡️ 3. 容错回退与 SQLite 并发事务保护
在高并发运行状态下,两个问题最为严重:一是大模型接口频繁抛出 429 Rate Limit Exceeded;二是多个线程同时调用 SessionDB 写入执行结果,触发 SQLite 的锁定异常(Busy Locked)。系统对这两个问题做了精妙的设计:
- 带抖动的指数退避重试 (Exponential Backoff with Jitter):
对于 Rate Limit 报错,系统基于退避公式
delay = min(max_delay, backoff_factor * (2 ** attempt)) + random.uniform(0, jitter)进行避峰重试,避免形成“同步并发冲击波”。 - 数据库写事务排队机制:
在多线程向底层
hermes_state.py更新状态时,底层事务强制调用会话锁检测并开启排队,将并发写事务化为单链表,在不锁定数据库主进程的前提下实现数据安全落地。
🔗 本章子任务深入剖析专栏
为深度掌握批处理引擎并发,推荐阅读以下子技术专题: