AIAgent 内核决策流与 Prompt 缓存保护
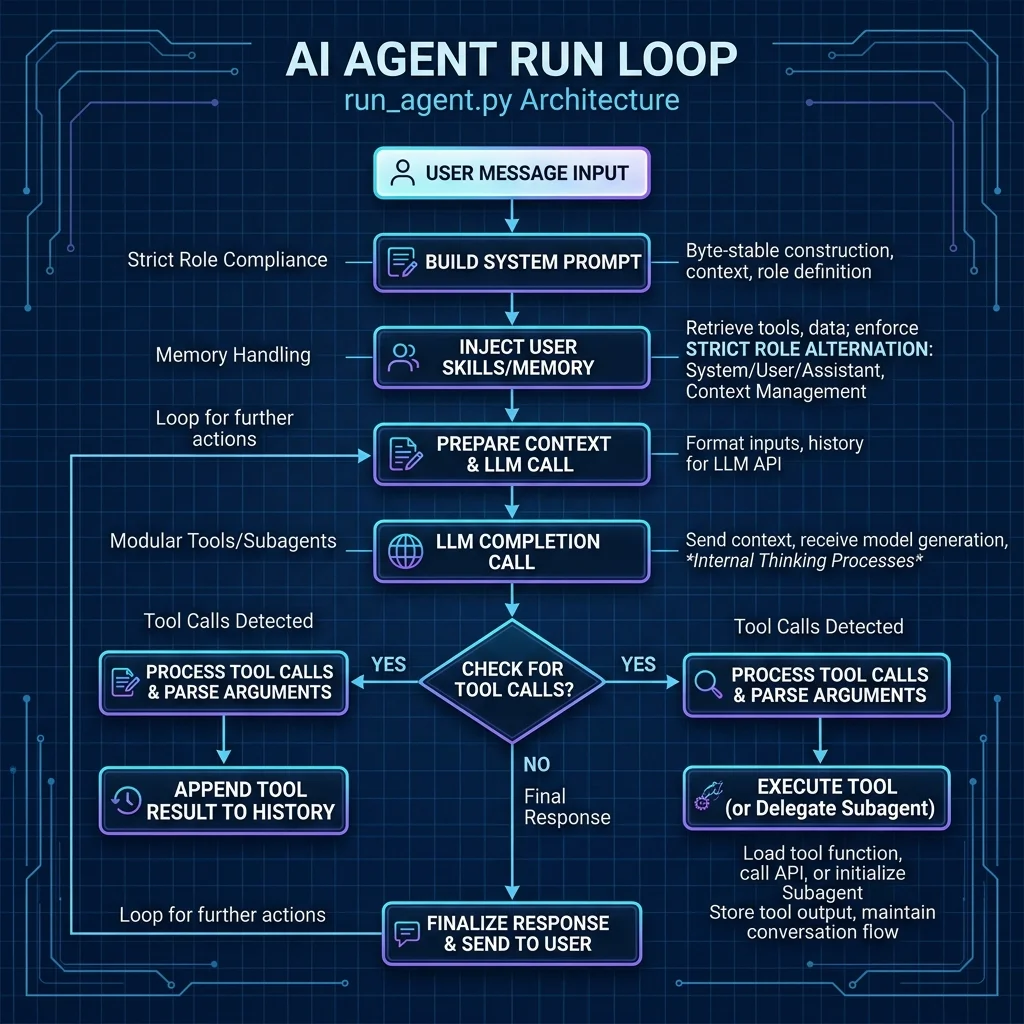
🧠 1. AIAgent 核心配置与生命周期控制
主大脑 AIAgent 类定义在 run_agent.py 中,其 __init__ 构造器包含多个参数。初学者重点需要掌握以下几个核心配置属性:
max_iterations(默认90):控制单个 Turn 内智能体连续调用工具的最大循环次数,到达该值将强行终止以防止失控的死循环。iteration_budget:定义本次请求的 Token 计算预算(包含输入、输出和思考),一旦预算耗尽则拒绝后续的大模型请求。provider与model:指定当前主会话的推理后端服务(如openai,anthropic,deepseek)和具体的模型名称。enabled_toolsets:工具箱白名单。仅允许大模型感知和调度该名单内的工具。_budget_grace_call(布尔型):优雅退出的“余次保证”标记。当 Token 预算在工具执行中耗尽时,系统仍会预留最后一次单 Turn 交互,允许大模型输出一句对用户的妥善回复。
🔄 run_conversation 会话主循环详解
每次用户发送提问,系统都会调用 AIAgent.run_conversation()。它是在 agent/conversation_loop.py 支撑下运转的一个循环:
# run_conversation 伪代码逻辑演示
def run_conversation(self, user_message, ...):
    # Step 1: 从 DB 加载会话历史,构建 System Message 与 Caching 锚点
    messages = self._prepare_session_history(user_message)

    while api_call_count < self.max_iterations and self.iteration_budget.remaining > 0:
        # Step 2: 发送请求给 LLM
        response = self.client.chat.completions.create(
            model=self.model, messages=messages, tools=self.get_tool_schemas()
        )

        # Step 3: 若是大模型给出的回复直接退出
        if not response.tool_calls:
            self._save_to_db(response.content)
            return response.content

        # Step 4: 循环拦截并串行分派 tool_calls
        for tool_call in response.tool_calls:
            result = self.handle_function_call(tool_call.name, tool_call.args)
            messages.append(self.format_tool_result_message(tool_call.id, result))

        api_call_count += 1
🔒 2. Prompt 缓存保护(Caching 保护三铁律)
为避免缓存击穿带来的高延迟和双倍 Token 计费,Hermes 在代码设计上通过三大防御机制来锁死缓存前缀的稳定性:
🛡️ 铁律一:Byte-stable System Prompt(有序的 JSON schema)
在 agent/system_prompt.py 的 format_tools_for_system_message() 方法中,每次在把工具 Schema 组装进 System Prompt 时,系统绝不使用无序的 Python 字典,而是进行硬性升序排序并强行去除缩进空格:
# 字节级稳定提示词实现
def format_tools_for_system_message(tools_list: list) -> str:
    # 强制排序以规避因 Python dict 哈希随机化导致的字节流改变
    sorted_tools = sorted(tools_list, key=lambda x: x["name"])
    return json.dumps(sorted_tools, sort_keys=True, separators=(',', ':'))
🔄 铁律二:严格角色校直(Role Alternation Control)
某些 LLM 厂商对消息队列中的 role 交替非常严苛。如果开发者在使用 Skills 或 Plugin 时意外塞入了两个连续的 user 消息,或者将 tool 消息插在了错误的序列里,都会引发服务端接口报错。在 agent/agent_runtime_helpers.py 中,系统自动对历史消息数组进行检查与校直:若出现连续的 user 消息,底层自动将其内容在文本层面通过换行符合并为一条大 user 消息;若发现缺失 assistant 响应的 tool 结果,自动在中间插入一个合成的空白回复。
🚫 铁律三:禁止动态 System Prompt 注入
任何包含动态时间戳(如“当前时间是 10:21:55”)、运行负载或瞬时路径的系统元数据严禁直接注入 System Prompt 头部。这些动态数值会使缓存瞬间作废。Hermes 要求所有这类动态数值必须作为 user 消息或者作为工具调用返回值(如 get_system_time())提供给模型,保证 System Prompt 字节序列坚固如初。
📉 3. 轨迹自适应压缩细节 (Context Compaction)
随着 Turn 轮次叠加,会话 Token 数量会暴涨。为了防止爆上下文并节省 Caching 开销,系统在 agent/conversation_compression.py 中实现了一套压缩算法。流程由以下时序驱动:
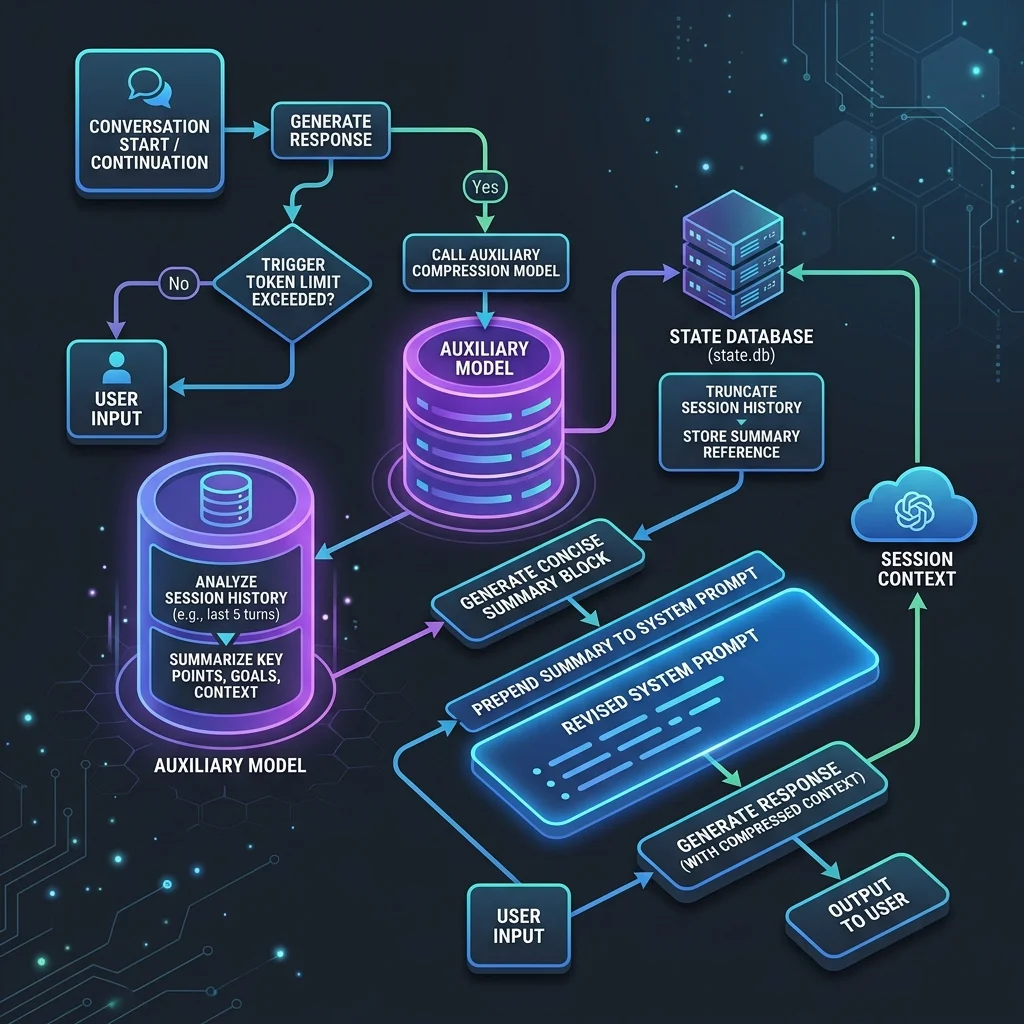
- 触发阈值条件:当会话 Token 数量达到大模型主窗口的
threshold_percent时,主循环会自动触发压缩阶段。 - 压缩与 Summary 生成:系统调用
auxiliary.compression.model指向的辅助模型,把即将被裁剪的历史轮次发给它进行要点提炼,生成 concise markdown 格式的Summary块。 - System Prompt 头部拼接:生成完毕后,系统将该 Summary 插入到系统提示词头部的固定锚点位置:
[Historical Summary] {Summary} [End of Historical Summary] - 数据库会话截断:新会话开始前,系统把旧历史做分割存储,然后直接在数据库中删除被总结的中间轮次,仅在内存和
state.db中保留最新的尾部消息,使得首字延迟暴跌。
🤝 4. 多智能体派发与并发截断保护
当大任务被分解时,AIAgent 会在 Turn 中决策出调用 delegate_task。这一过程包含如下关键路径:
- 分派路径:在
run_agent.py中,_dispatch_delegate_task方法会拦截这一动作,它不作为一个简单的 Python 函数执行,而是动态从tools/delegate_tool.py导入delegate_task模块,为子任务拉起全新的AIAgent线程。 - 子智能体限流防死锁 (`_cap_delegate_task_calls`):
为了规避模型失控发起的并行子智能体风暴导致费用激增,系统在
run_agent.py的_cap_delegate_task_calls()中会强制对tool_calls列表进行清洗:# 并发截断处理 delegate_count = sum(1 for tc in tool_calls if tc.function.name == "delegate_task") if delegate_count > MAX_CONCURRENT_CHILDREN: # 强行截断超出限制的子智能体调用,超出的部分被丢弃,待后续轮次重新调度 tool_calls = [tc for tc in tool_calls if ...] logger.warning("Truncated excess delegate_task calls to enforce concurrency limits.") - Kanban 协作:子智能体会注册到项目
plugins/kanban/状态中,主智能体可以通过看板状态轮询子进程执行,并整合产出最终结果。
🔗 本章子任务深入剖析专栏
为深度掌握智能体内核,推荐阅读以下子技术页面,直达具体的 Python 源文件逐行解密: