智能体对话主循环决策机理与并发控制
解密 run_agent.py 与 agent/conversation_loop.py 中 run_conversation() 的生命周期状态机
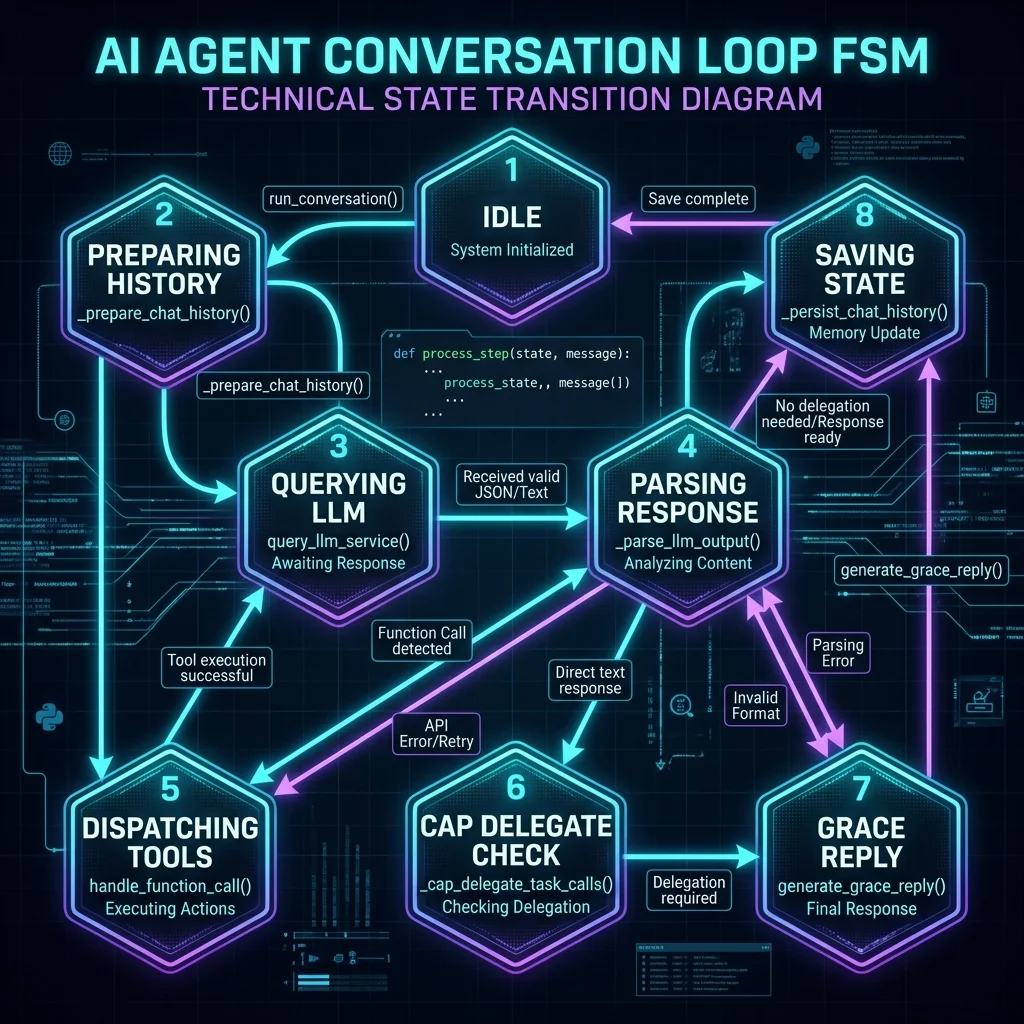
📊 图 2-1-1:AI Agent 决策流状态机与 API 锁死流转图
🔄 1. 会话主循环流程深度透视
在 agent/conversation_loop.py 中的 run_conversation() 函数里,智能体维持着一个状态机。它并非简单地执行单次 LLM 请求,而是进入自适应的工具调用循环。具体步骤包括:
- 状态初始化:从数据库加载会话上下文和长时记忆,组装成原始的
messages。 - 中断预检:每次循环开始时检测
agent._interrupt_requested。用户发送新消息或在网关中发送取消信号均可触发中断。 - LLM 协商:调用
client.chat.completions.create发起请求,传入api_messages和工具集列表。
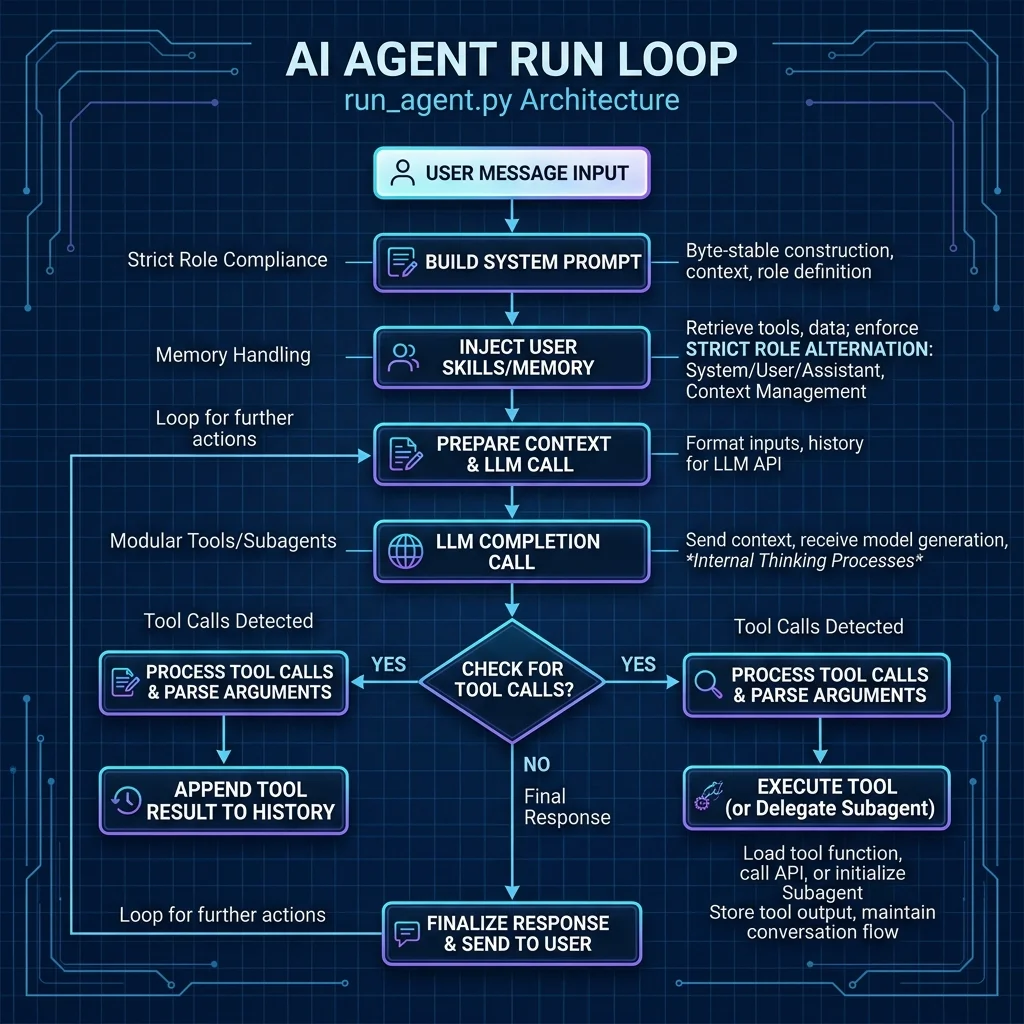
📊 图 2-1-2:AIAgent 决策流与缓存优化整体时序图
🛡️ 2. 并发限流与 grace_call 机制
系统应对 Token 预算消耗和多智能体失控并发的核心设计如下:
🚦 优雅退出 (grace_call)
当 iteration_budget.remaining 归零时,为了避免智能体突然“中断阻截”,系统会启动 _budget_grace_call。给予模型最后一次只读交互机会,此时系统清空 tools 定义,强制大模型只能面向用户生成最后的总结回复。
🛑 子智能体截断 (_cap_delegate_task_calls)
当大模型并行分派过多的 delegate_task 时,会造成大量本地资源消耗。系统会将并发子任务截断在 MAX_CONCURRENT_CHILDREN 限制内,并将溢出任务转换成警告格式反馈给大模型,避免失控。